AI研究壽命短|AI頻迭代 44%研究結果逾一年失效 史丹福檢視50項發現 缺陷多已改善
原文刊於信報財經新聞「CEO AI⎹ EJ Tech」
大型語言模型(LLM)更迭快速,每隔數月都有新版本問世,模型能力以月為單位躍進。美國史丹福大學研究人員近日重新檢視20個模型,當中關於LLM的50項被廣泛引用的研究結果,涵蓋諂媚、越獄、長上下文、文化偏見、推理、判斷等範疇。結果顯示,在發表後的15個月內,近半(44%)結論在新模型身上已不再成立。至於這些已失效的結論,大多屬舊模型的能力缺陷,如今新模型經已作出改良。
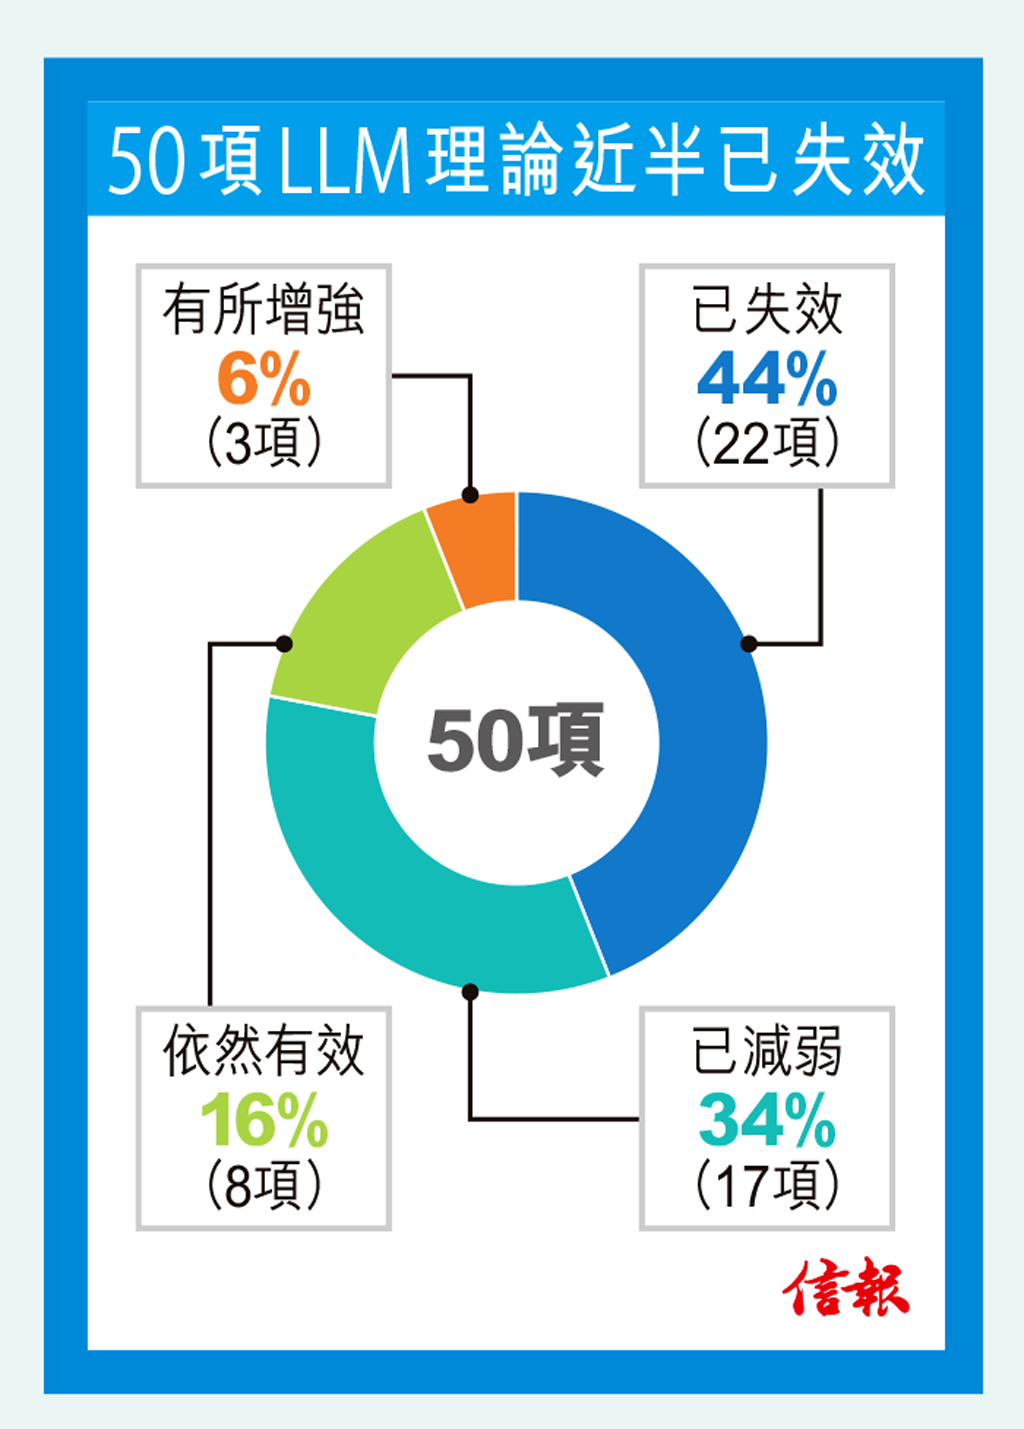
研究人員分析2024年7月至2026年9月期間,由8間模型開發者發布的20個模型,涵蓋規模大小、權重開放與否等多種情況。研究員根據今年9月的剩餘效果,將結論分為失效、減弱、持續及增強這4類。在50項測試論點之中,22項(44%)在當今模型已失效;另有17項(34%)論點顯著減弱,8項(16%)論點依然有效,只有3項(6%)的論點有所增強。
截至2026年9月30日,重測的50項結論之中,在發表6個月後,已經有4%失效,一年後升至16%,兩年後更飆至39%。研究推算,在22項已失效的結論中,由發表到失效,平均需時僅約15.7個月,中位數大約14.7個月。主要涉及能力缺陷類,新模型已大幅改善,例如數字母(舉例來說,「strawberry」有多少個r)、其他進制的算術、長上下文中間事實提取、虛構引用、被質疑後放棄正確答案、會議摘要洩漏私隱、阿拉伯語的非回答率高於英語等。
已減弱17項結論中,結構性限制仍在,但已經較弱,例如「逆轉詛咒」(The Reversal Curse)、兩跳(Two-hop)問題、多輪指令、殘餘社會偏見、偏好較長回答、虛構套件名稱、利基領域幻覺、越獄與提詞注入脆弱性等。
仍奉承用戶 不擅開放式回答
目前成立或增強的11項,多屬偏好與判斷層面,而非純能力問題,例如奉承附和用戶、裁判偏袒自己的答案、對開放式問題的回答幾乎相同、政治取向偏左、應該棄權時仍然作答等。
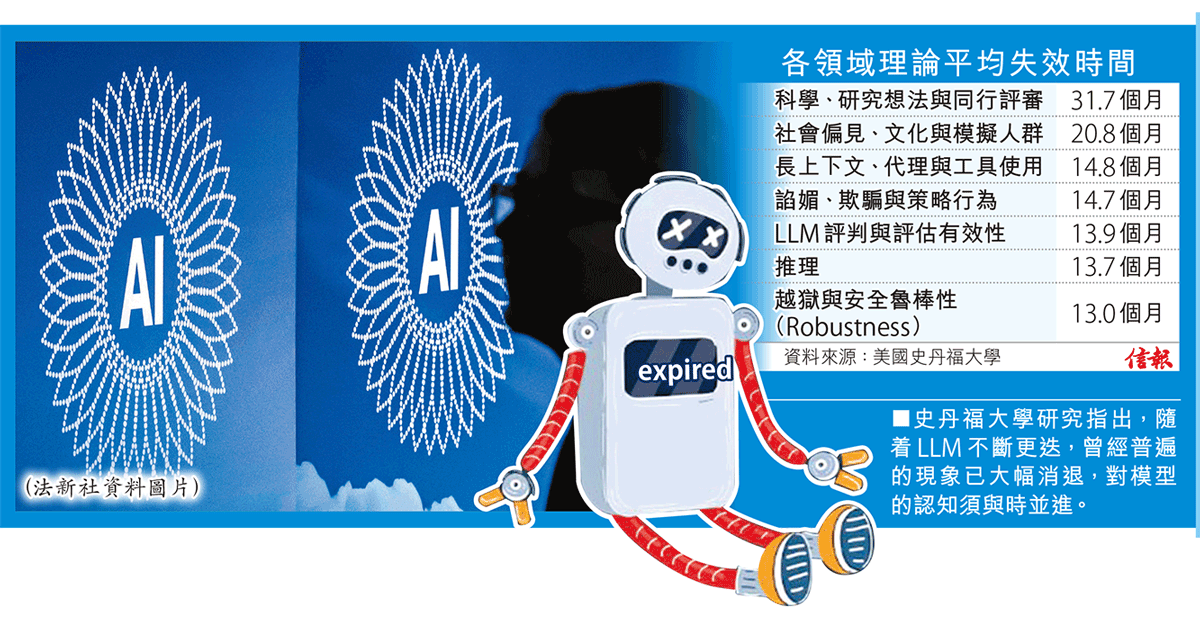
平均過期時間方面,不同研究領域長短不一【見表】。後訓練流程改善愈多的問題,通常過期速度較快,偏見與判斷類別較慢。
「幻覺」銳減 GPT虛構文獻比例近零
整體而言,民眾對於AI的認知,可能只有短暫「保質期」。
目前部分學術會議,仍以「幻覺引用」作為拒稿理由,以2023年美國學者在學術期刊《科學報告》的研究為例,當時GPT-3.5列出的參考文獻,高達55%引用是捏造的。然而,現在用GPT-6.1-Sol及Claude Sonnet 5.5重測,虛構引用率已降至近0%。
研究指出,曾經普遍的現象如今大幅消退,不應假設舊模型得出的結論,在現時更強的模型依然成立。對於研究社群與政策制定者,對AI行為的認知需要持續更新,認知框架若停滯不前,便會逐漸脫節。真正有價值的知識,結論從來不是一成不變,而是不斷質疑與更新的過程。同時,研究成果不妨盡快發表,不然收到第一輪修改意見時,再研究結論恐怕已過時。
支持EJ Tech

 如欲投稿、報料,發布新聞稿或採訪通知,按這裏聯絡我們。